企業サイトはAIクローラーを拒否すべき?robots.txtとLLMOの確認ポイント
2026/11/22
結論:企業サイトのAIクローラーは、一括で拒否するのではなく、検索結果に表示したい公開情報、AI学習への利用方針、外部へ出してはいけない非公開情報を分けて設定することが大切です。ChatGPT検索への表示を目指すなら公開ページへのOAI-SearchBotのアクセスを検討し、学習への利用はGPTBotについて別に判断します。機密情報はrobots.txtに頼らず、認証や公開範囲そのものを見直してください。
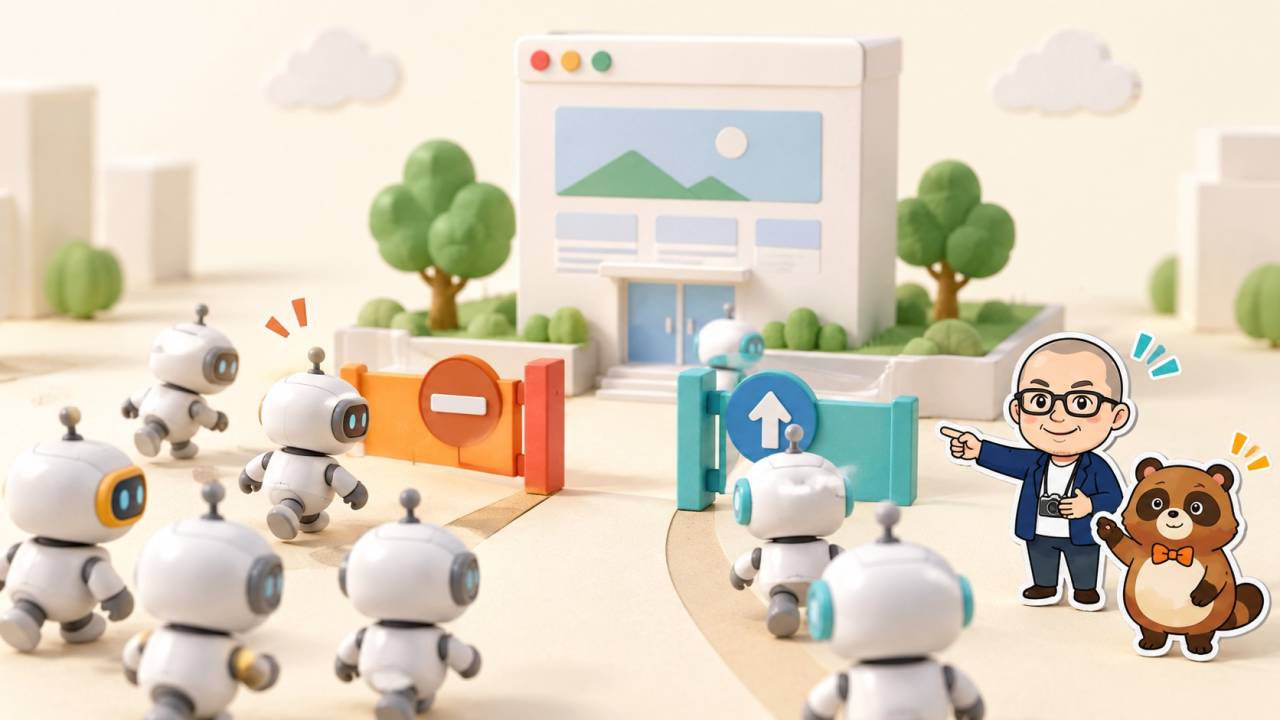
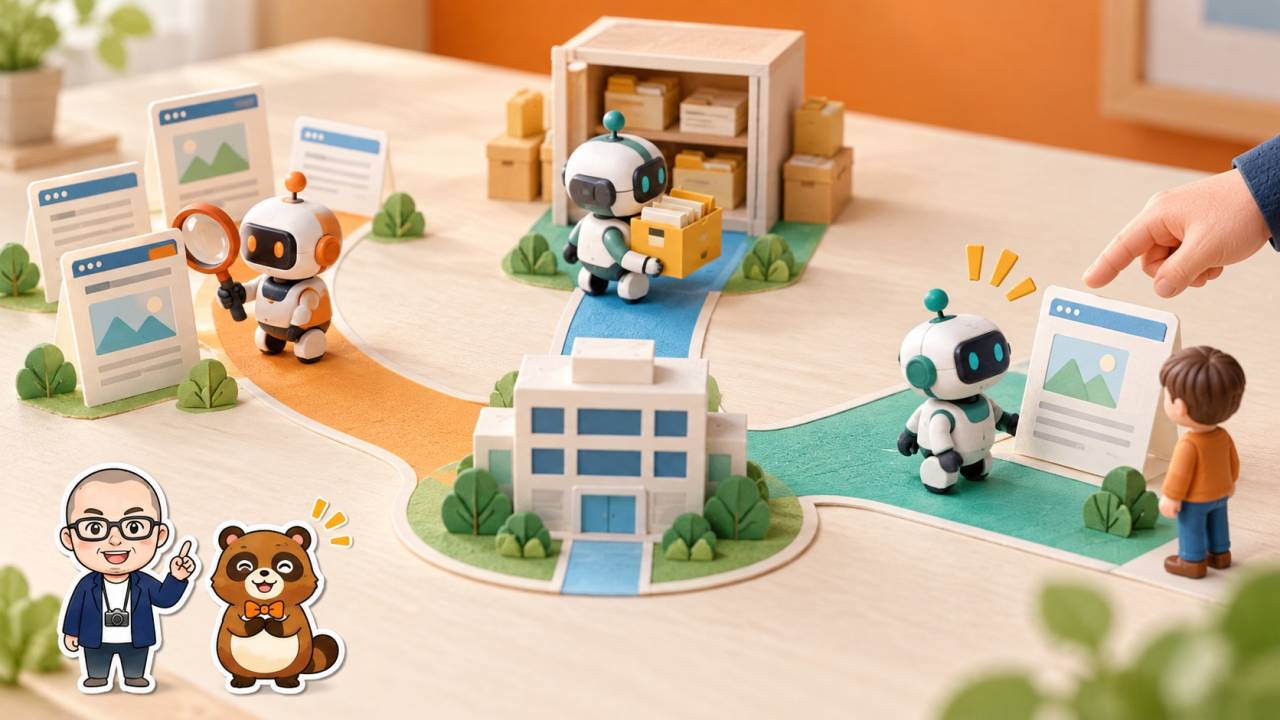
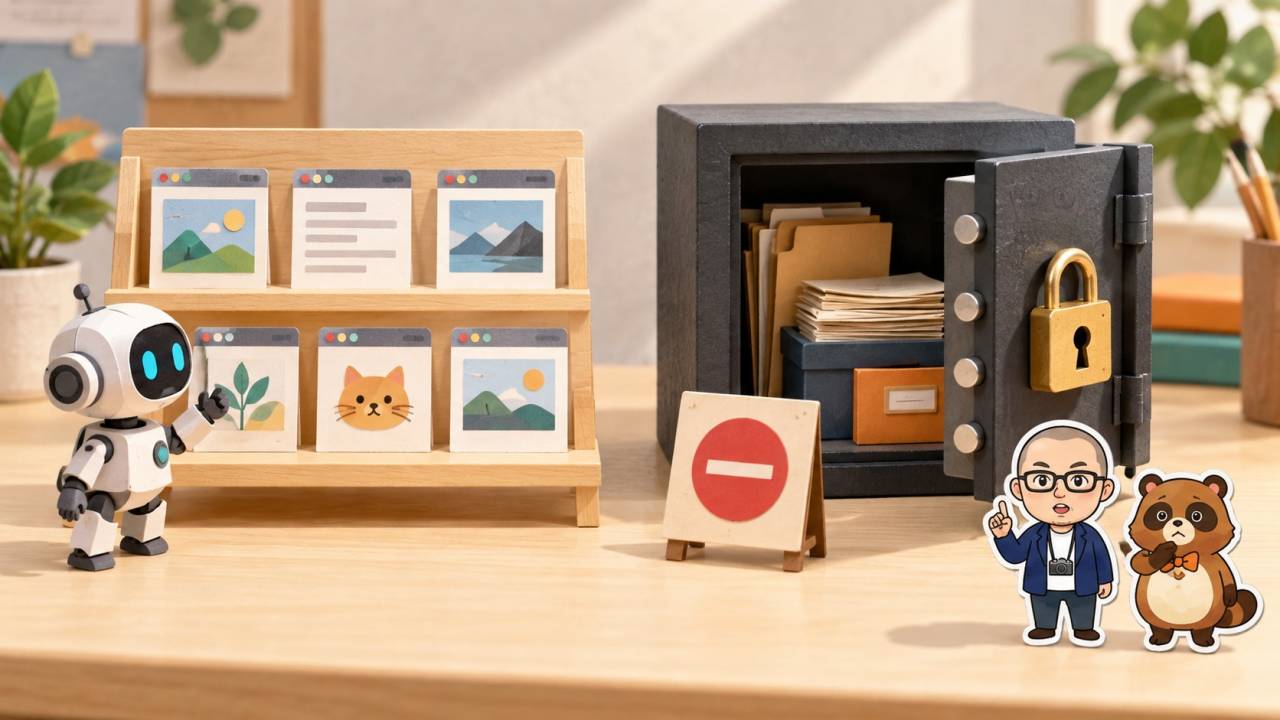
※この記事のアイキャッチ画像と本文画像はAIで生成したイメージです。
最初に確認する3点
- 検索に出したいか:会社概要、サービス、実績、FAQなど、見つけてもらいたい公開情報を決める
- 学習を許可するか:検索用クローラーと学習用クローラーを同じものとして扱わない
- 秘密情報がないか:顧客情報や社内資料はrobots.txtではなく、ログインやアクセス制限で保護する
AIクローラーはすべて同じ役割ではない
OpenAIの公式情報では、OAI-SearchBotとGPTBotはrobots.txt上で別のユーザーエージェントとして扱われます。OAI-SearchBotはChatGPTの検索機能にウェブサイトを表示するためのもので、GPTBotは生成AIモデルの改善に利用される可能性があるコンテンツを収集するためのものです。
| 種類 | 主な役割 | 企業サイトで考えること |
|---|---|---|
| OAI-SearchBot | ChatGPT検索でウェブページを見つけ、表示する | 公開情報を検索で見つけてもらいたいか |
| GPTBot | 生成AIモデルの改善に使われる可能性がある情報を収集する | 自社コンテンツの学習利用を許可するか |
| ChatGPT-User | 利用者の操作を受けてページへアクセスする | 自動巡回とは異なり、robots.txtが常に適用されるとは限らない |
robots.txtとLLMOを見直す5つの手順
1.公開情報と非公開情報を分ける
会社概要、サービス内容、対応地域、料金の考え方、よくある質問などは、検索やAIの回答で見つけてもらいたい公開情報です。一方、顧客の個人情報、契約前の資料、社内の数値、限定公開の動画などは、クローラー設定以前に公開場所へ置かないことが基本です。
2.現在のrobots.txtを確認する
通常はサイトのドメイン末尾に/robots.txtを付けると内容を確認できます。Chain-Movies公式サイトは2026年11月22日時点で、すべてのユーザーエージェントにサイト全体へのアクセスを許可し、サイトマップの場所を案内する設定です。
ただし、robots.txtの内容だけで検索表示やAI回答への掲載が保証されるわけではありません。ページが読み取れる状態か、内容が明確か、内部リンクやサイトマップで見つけられるかも確認します。
3.検索表示と学習利用を別々に判断する
「ChatGPT検索には表示したいが、学習目的の収集は許可しない」という方針も設定できます。たとえば、次の記述はOAI-SearchBotを許可し、GPTBotを拒否する考え方の一例です。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
既存の設定や他のクローラーへの指示と競合する場合があるため、そのまま貼り付けず、CMSやサーバーの仕様を確認してから反映してください。OpenAIは、OAI-SearchBotに関するrobots.txtの変更が検索システムへ反映されるまで、およそ24時間かかる場合があると案内しています。
4.検索から外したいページはnoindexも確認する
Googleは、robots.txtを検索結果からページを除外する目的には適切ではないと説明しています。検索結果へ出したくないページは、必要に応じてnoindexや認証を使います。
注意したいのは、robots.txtでクロールを拒否したページにnoindexを置いても、クローラーがその指示を読めない可能性があることです。アクセス制御、クロール制御、検索結果からの除外は目的が異なります。
5.変更後はアクセスと表示を確認する
設定変更後は、robots.txtの表示、主要ページのHTTP応答、サイトマップ、Google Search ConsoleのURL検査、サーバーログなどで影響を確認します。ChatGPT検索での見え方は、会社名やサービス名について実際に質問し、古い情報や誤解がないか定期的に点検します。
設定変更前のチェックリスト
- 検索やAI回答で見つけてもらいたいページを一覧にした
- OAI-SearchBotとGPTBotの方針を分けて決めた
- 顧客情報や限定資料を公開領域へ置いていない
- 検索から外すページのnoindexと認証を確認した
- サイトマップと主要ページへの内部リンクを確認した
- 変更後の確認担当者と点検日を決めた
よくある質問
Q.AIクローラーを許可すれば、必ずChatGPTの回答に表示されますか?
A.いいえ。クロールを許可することは発見されるための前提の一つですが、表示は保証されません。会社情報やサービス内容をページ内で明確にし、更新日、運営者、根拠、内部リンクも整えます。
Q.GPTBotを拒否すると、ChatGPT検索にも出なくなりますか?
A.OpenAIはOAI-SearchBotとGPTBotの設定は独立していると説明しています。検索表示を希望する場合はOAI-SearchBot、学習利用の方針はGPTBotについて個別に設定します。
Q.robots.txtで顧客専用ページを守れますか?
A.守れません。robots.txtはクローラーへの指示であり、アクセスを制限する仕組みではありません。ログイン、IP制限、適切な権限設定などが必要です。
Q.設定は一度行えば終わりですか?
A.サイト改修、CMS変更、新しいAI検索サービスの登場に合わせて見直します。少なくとも主要ページの追加や公開範囲の変更時には確認してください。
Q.LLMOではrobots.txt以外に何を整えますか?
A.「誰が、誰に、何を提供し、どこで対応するか」を明記し、サービスページ、会社概要、FAQ、実績、記事を内部リンクでつなぎます。構造化データやサイトマップも、実際の内容と一致させる必要があります。
Chain-Moviesが支援できること
Chain-Movies株式会社は、企業サイトの現状整理、LLMOを意識した情報設計、ホームページ開発、robots.txtやサイトマップなどの技術確認、FAQ・サービスページ・記事の改善まで支援します。設定だけで終わらせず、会社の強みと支援範囲が読み手やAIに正確に伝わる状態を一緒につくります。
支援内容はAI活用・業務改善・LLMO支援のページで紹介しています。名古屋市を拠点に全国対応が可能です。遠方の場合は交通費をご相談します。
あわせて読みたい:企業サイトのLLMO対策は何から始める?AIに会社情報を正しく伝える7つの整備項目/企業サイトのFAQは何を書く?問い合わせ前の不安を減らす5つの整理手順
自社サイトのLLMO設定を確認しませんか
初回相談は無料です。現在のサイト、発信したいサービス、AI検索で起きている課題を伺い、優先して確認するページと設定を整理します。
出典
- OpenAI「Overview of OpenAI Crawlers」
- Google Search Central「robots.txt の概要」
- Google Search Central「robots meta タグ、data-nosnippet、X-Robots-Tag の仕様」
確認日:2026年11月22日(初回確認:2026年9月11日)
本記事は一般的なウェブサイト運用情報です。クローラーの仕様や検索表示は変更される場合があります。重要な設定変更は最新の公式情報と利用環境を確認して行ってください。